„Wir brauchen KI!“ – Aber sind wir überhaupt bereit dafür?
„Wir brauchen KI.“ Dieser Satz fällt inzwischen in vielen Unternehmen. Manchmal folgt direkt der zweite: „Kann die IT Abteilung uns nicht einfach eine lokale Lösung aufsetzen? Dann schauen wir, was wir damit machen.“
Ich halte die Neugier auf künstliche Intelligenz für richtig. Problematisch wird es, wenn aus einer technologischen Erwartung ein Projektauftrag ohne Geschäftsproblem, Verantwortlichkeiten und messbares Ziel wird. Dann kann die IT technisch alles richtig machen – und das Vorhaben trotzdem wirtschaftlich scheitern.
Dieser Beitrag ist eine Orientierung für Geschäftsführung, Fachbereiche und IT-Verantwortliche. Es geht nicht um die Installation eines Sprachmodells, sondern um die Frage, welche Mindestvoraussetzungen ein Unternehmen für einen sinnvollen KI-Einsatz schaffen sollte – und wann der lokale Betrieb eine gute Entscheidung sein kann.
1. Eine funktionierende KI ist noch kein Geschäftsergebnis
Ein Prototyp beantwortet Fragen, formuliert E-Mails und fasst Dokumente zusammen. Das ist eindrucksvoll. Aber welche Arbeitszeit wird tatsächlich eingespart? Wer darf die Antworten verwenden? Was passiert bei einer falschen Auskunft? Und wer hält die Wissensbasis aktuell?
Ich würde deshalb nicht mit der Auswahl eines Modells beginnen, sondern mit einem konkreten Geschäftsproblem. Beispielsweise: Mitarbeitende verbringen zu viel Zeit damit, interne Richtlinien zu finden. Daraus lässt sich ein überprüfbares Ziel ableiten: weniger Suchaufwand bei mindestens gleichbleibender fachlicher Qualität.
Nicht jeder Prozess benötigt generative KI. Für fest definierte Regeln, eindeutige Datenzuordnungen oder einfache Benachrichtigungen ist klassische Automatisierung häufig nachvollziehbarer, günstiger und robuster.
2. Wann lohnt sich der Blick auf lokale KI?
„Lokal“ bedeutet nicht automatisch sicherer, günstiger oder leistungsfähiger. Ich unterscheide zunächst drei Betriebsmodelle:
| Modell | Typischer Vorteil | Typische Herausforderung |
|---|---|---|
| Externer KI-Dienst | Schneller Einstieg, elastische Kapazität | Vertrags-, Datenschutz- und Abhängigkeitsfragen |
| Eigener Betrieb / On-Premises | Mehr Kontrolle über Infrastruktur und Datenwege | Investitionen, Wartung, Kapazität und Betriebskompetenz |
| Hybrid | Je Anwendungsfall passende Verarbeitung | Komplexere Datenflüsse und Zuständigkeiten |
Lokale KI wird besonders interessant, wenn sensible Daten innerhalb definierter Betriebsgrenzen verarbeitet werden sollen, eine verlässliche Nutzungsauslastung besteht oder Integrationen in interne Systeme wichtig sind. Auch Anforderungen an Latenz, Netzunabhängigkeit und individuelle Kontrolle können dafür sprechen.
Dagegen sprechen können hohe Hardwarekosten, schwankende Last, der Wunsch nach besonders großen Modellen und fehlende Betriebskapazitäten. Für die Entscheidung zählt nicht nur der Anschaffungspreis einer GPU, sondern der Gesamtaufwand über die Nutzungsdauer: Strom, Kühlung, Speicher, Lizenzen, Sicherheitsupdates, Monitoring, Personal, Ausfallvorsorge und Modellwechsel.
Vor allem gilt: Daten bleiben nicht schon deshalb geschützt, weil das Modell im eigenen Rechenzentrum läuft. Auch dort braucht es Zugriffsregeln, Protokollierung, Schutz vor missbräuchlichen Eingaben und eine kontrollierte Einbindung externer Komponenten.
3. Der Projektauftrag gehört dem Unternehmen – nicht allein der IT
Ein KI-Projekt braucht einen Sponsor, der den geschäftlichen Nutzen verantwortet, und einen Prozesseigner, der die fachliche Eignung bewertet. Die IT verantwortet Plattform, Integration, Betrieb und technische Sicherheit. Datenverantwortliche entscheiden über Qualität, Freigabe und Pflege der Wissensquellen. Datenschutz, Informationssicherheit und gegebenenfalls Rechts- und Compliance-Funktionen prüfen die für ihren Bereich relevanten Anforderungen.
| Aufgabe | Primäre Zuständigkeit |
|---|---|
| Ziel, Budget, Priorisierung | Geschäftsführung / Sponsor |
| Use Case und fachliche Abnahme | Fachbereich / Prozesseigner |
| Modellbetrieb, WebUI, Integration | IT / Plattformteam |
| Datenfreigabe, Aktualität, Berechtigungen | Daten- und Fachverantwortliche |
| Prompt- und Anwendungsdesign | Anwendungsteam gemeinsam mit Fachbereich |
| Antwortqualität und Testfälle | Fachlich qualifizierte Prüfer |
| Datenschutz, Sicherheit, regulatorische Bewertung | Zuständige Kontrollfunktionen |
| Nutzenmessung und Fortführungsentscheidung | Sponsor und Prozesseigner |
In kleineren Unternehmen kann eine Person mehrere Aufgaben übernehmen. Trotzdem sollten die Entscheidungen nachvollziehbar zugeordnet sein. Besonders wichtig ist die Trennung von technischer Funktion und fachlicher Richtigkeit: Die IT kann den Dienst verfügbar halten, aber nicht allein garantieren, dass z.B. eine Antwort zu einer Personalrichtlinie oder Vertragsklausel korrekt ist.
Das NIST AI Risk Management Framework betont deshalb Governance, Kontextanalyse, Messung und Risikobehandlung als zusammenhängende Aufgaben – nicht als reine Installationsschritte.
4. Welche Daten braucht die KI – und wann hilft RAG?
Ein Sprachmodell kennt die internen Dokumente eines Unternehmens nicht automatisch. Für einen internen Wissensassistenten müssen zunächst Quellen identifiziert, freigegeben und gepflegt werden: Richtlinien, Handbücher, Prozessbeschreibungen oder Produktdokumentationen.
Hier kann Retrieval-Augmented Generation (RAG) sinnvoll sein. Vereinfacht gesagt sucht die Anwendung zu einer Frage passende Inhalte in einer aufbereiteten Wissensbasis und stellt diese dem Sprachmodell als Kontext bereit. Das Modell kann darauf gestützt antworten und idealerweise die Fundstellen anzeigen.
RAG ist aber kein Wahrheitsgarant. Unvollständige Dokumente, schlechte Suche, widersprüchliche Versionen oder unpassende Textabschnitte führen weiterhin zu fehlerhaften Antworten. Besonders kritisch: Zugriffsrechte müssen bereits beim Abruf der Quellen durchgesetzt werden. Eine Chatoberfläche darf nicht zum Umweg um bestehende Dokumentenberechtigungen werden.
Vor dem Aufbau einer Wissensbasis würde ich klären: Welche Quellen gelten als verbindlich? Wem gehören sie? Wie oft ändern sie sich? Welche Dokumente dürfen für welche Nutzergruppen abgerufen werden? Wie werden Löschung, Korrekturen und Versionswechsel umgesetzt? Welche Testfragen und erwarteten Antworten dienen der Qualitätsprüfung?
Für strukturierte Geschäftsprozesse sind klassische Datenbankabfragen oder gezielte Schnittstellen oft geeigneter als ein RAG-Index. Die Architektur sollte dem Informationsproblem folgen, nicht einem Schlagwort.
5. Was wird technisch und organisatorisch benötigt?
Die eigentliche KI-Plattform umfasst mehr als ein Modell. Typischerweise werden eine passende Inferenzumgebung, ausreichend Rechen- und Speicherkapazität, Netzwerkzugänge, Identitäts- und Berechtigungsmanagement, Sicherheitskontrollen, Überwachung, Backup- und Wiederanlaufverfahren sowie ein geregelter Updateprozess benötigt.
Für die Nutzerfreundlichkeit bietet sich eine WebUI an: ein zentraler, verständlicher Zugang, möglichst mit vorhandener Anmeldung, klaren Nutzungsregeln, Quellenanzeige und Feedbackmöglichkeit. Werkzeuge wie Open WebUI sind mögliche Bausteine, aber keine vollständige Unternehmenslösung allein durch ihre Installation.
Der entscheidende Punkt ist die Integration: Können Mitarbeitende die Anwendung im normalen Arbeitsablauf nutzen? Werden Zugriffsrechte respektiert? Ist klar, welche Eingaben gespeichert werden? Wer reagiert auf Fehlermeldungen? Und wie werden Modelle, Prompts und Datenänderungen kontrolliert ausgerollt?
Auch Prompting ist keine einmalige Zauberformel. Für produktive Anwendungen braucht es versionierte Anweisungen, fachliche Testfälle, definierte Grenzen und Regressionstests nach Änderungen. Ein überzeugender Demo-Prompt ist noch keine dauerhaft belastbare Anwendung.
6. Vom Chatfenster zur Geschäftsprozessautomatisierung
Eine interne Chatoberfläche ist ein guter Einstieg, aber nicht das Ende der Möglichkeiten. KI kann Dokumente klassifizieren, Informationen extrahieren, Antwortentwürfe erstellen oder Vorgänge für Mitarbeitende vorbereiten. Über APIs und Workflow-Systeme können solche Ergebnisse an bestehende Geschäftsprozesse angebunden werden.
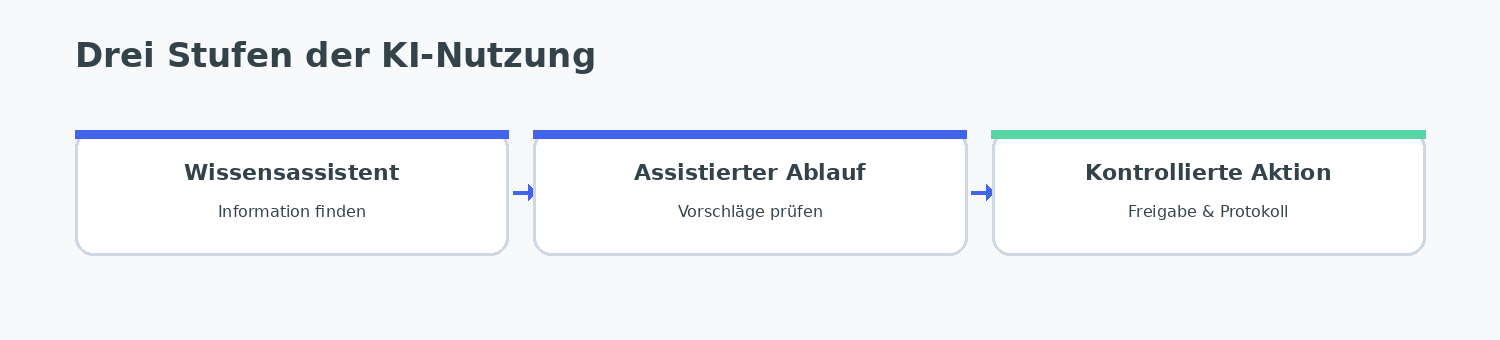
Ich unterscheide drei Stufen: Ein Wissensassistent hilft bei der Informationssuche. Eine assistierte Prozesslösung erzeugt Vorschläge, die ein Mensch prüft. Eine kontrollierte Automatisierung kann nach definierten Regeln Aktionen auslösen – etwa einen Vorgang anlegen oder einen freigegebenen Datensatz aktualisieren.
Mit jeder Stufe steigen die Anforderungen an Rechte, Freigaben, Protokollierung, Fehlerbehandlung und Rückabwicklung. Ein System, das einen Textentwurf erstellt, benötigt andere Kontrollen als eines, das Kundendaten verändert oder externe Nachrichten verschickt. Autonom handelnde Agenten sollten deshalb nicht als zwangsläufiger nächster Schritt betrachtet werden.
7. Risiken, Recht und die Grenzen der Technik
Generative KI kann überzeugend formulieren und trotzdem falsch liegen. Zusätzlich bestehen Risiken durch vertrauliche Eingaben, ungeeignete Datenquellen und Prompt Injection: Dabei können manipulierte Inhalte aus Dokumenten oder Webseiten versuchen, das Verhalten der Anwendung zu beeinflussen. Das BSI beschreibt gerade solche indirekten Angriffe als relevante Schwachstelle anwendungsintegrierter Sprachmodelle.
Für Unternehmen in der EU sind zudem Datenschutzrecht und – abhängig von Rolle und konkretem Einsatz – Anforderungen des EU AI Act relevant. Insbesondere die Pflicht zu Maßnahmen für KI-Kompetenz nach Artikel 4 sollte in die Personal- und Einführungsplanung einfließen. Nicht jeder interne Chatbot ist automatisch ein Hochrisiko-KI-System; eine Einordnung muss anhand des tatsächlichen Einsatzes erfolgen.
Ich würde daher früh dokumentieren, welche Daten verarbeitet werden, wer Zugriff hat, wie lange Inhalte gespeichert werden, welche Entscheidungen Menschen vorbehalten bleiben und wie Fehler gemeldet werden. Eine rechtliche Bewertung ersetzt dieser Überblick ausdrücklich nicht.
8. Die Mindestanforderungen für einen sinnvollen Start
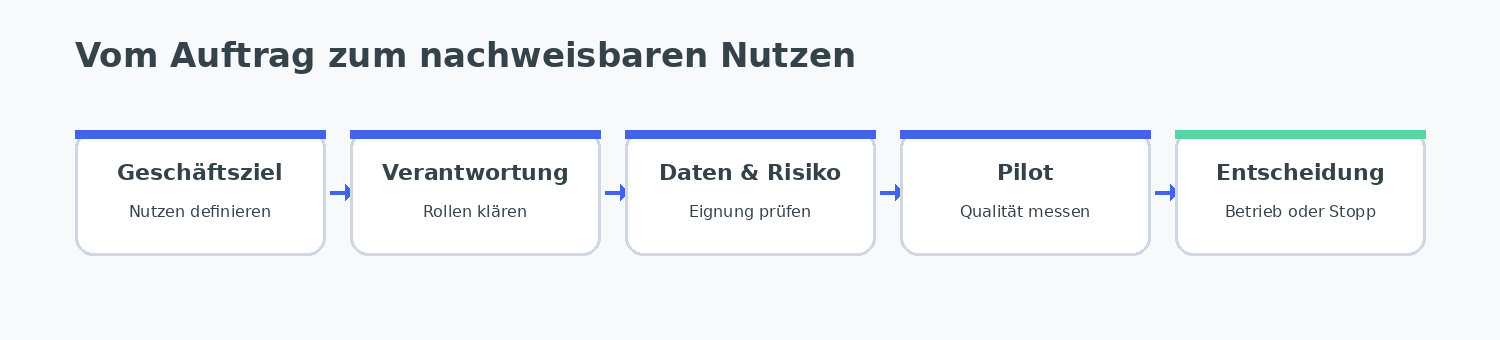
Bevor Budget in Hardware oder einen größeren Plattformaufbau fließt, sollte das Management sieben Fragen beantworten können:
- Welches konkrete Geschäftsproblem wollen wir verbessern – und warum ist KI dafür geeignet?
- Wer trägt die Verantwortung für Budget, Prozess, Daten, fachliche Qualität und Betrieb?
- Welche Daten dürfen genutzt werden, in welcher Qualität und mit welchen Zugriffsrechten?
- Woran messen wir Erfolg? Beispielsweise Bearbeitungszeit, Fehlerquote, Qualität und Nutzerakzeptanz.
- Welcher Betriebsansatz passt? Lokal, Cloud oder Hybrid – einschließlich laufender Kosten.
- Welche Risiken und Kontrollen gelten für den konkreten Einsatz, insbesondere bei automatisierten Aktionen?
- Wie ist der Pilot begrenzt, wer nimmt ihn ab und nach welchen Kriterien wird fortgesetzt oder gestoppt?
Diese Fragen sind keine bürokratische Hürde. Sie schützen Investitionen und Projektbeteiligte vor unklaren Erwartungen. Ein kleiner, sauber begrenzter Pilot mit repräsentativen Testfällen ist häufig sinnvoller als eine große Plattform ohne definierten Bedarf.
Fazit: Erst die Verantwortung, dann die Infrastruktur
Ich bin überzeugt, dass lokale KI für viele Unternehmen eine wertvolle Option sein kann – insbesondere dort, wo Kontrolle, Integration und der Umgang mit sensiblen Informationen eine große Rolle spielen. Sie ist aber eine technische Antwort auf Anforderungen, die vorher fachlich formuliert werden müssen.
Wenn die Geschäftsführung Ziele und Ressourcen bereitstellt, Fachbereiche die Qualität verantworten und die IT eine tragfähige Plattform betreibt, kann daraus echter Nutzen entstehen. Fehlen diese Grundlagen, bleibt selbst eine beeindruckende Installation oft nur eine Demo.
Nicht jedes Unternehmen braucht sofort eine eigene KI. Jedes Unternehmen, das KI erfolgreich einsetzen möchte, braucht jedoch einen klaren Zweck, benannte Verantwortliche und überprüfbare Ergebnisse.
Quellen und weiterführende Grundlagen
- NIST: AI Risk Management Framework 1.0 – Governance, Risikomanagement und Verantwortlichkeiten.
- EU AI Act, Artikel 4 – KI-Kompetenz – Anforderungen an geeignete Maßnahmen zur KI-Kompetenz.
- BSI: Indirect Prompt Injections – Sicherheitsrisiken bei eingebundenen externen Inhalten.
Stand der Einordnung: Oktober 2026. Anforderungen hängen vom konkreten Einsatz und dem jeweils geltenden Rechtsstand ab.