Docker-Healthchecks: Warum „Container läuft“ noch lange nicht „Anwendung funktioniert“ bedeutet
Ein Container kann seit Stunden als Up angezeigt werden und trotzdem genau das nicht mehr tun, wofür ich ihn gestartet habe.
Diese Unterscheidung klingt banal. In der Praxis ist sie für mich aber einer der Punkte, an denen sich ein Docker-Setup vom bloßen Starten einiger Container zu einem vernünftig betreibbaren System entwickelt.
docker ps beantwortet zunächst vor allem eine Frage: Läuft der Containerprozess noch?
Mich interessiert im Betrieb eine andere:
Kann der Dienst im Container seine eigentliche Aufgabe noch erfüllen?
Genau dafür sind Docker-Healthchecks gedacht. Sie sind allerdings nur so aussagekräftig wie die Prüfung, die ich ihnen mitgebe.
„Up“ ist kein Funktionstest
Nehmen wir einen Webdienst. Der Hauptprozess läuft, der Container wurde nicht beendet und Docker zeigt ihn entsprechend als aktiv an.
Das bedeutet noch nicht zwingend, dass die Anwendung HTTP-Anfragen sinnvoll beantworten kann.
Ein Prozess kann hängen. Eine Anwendung kann zwar laufen, aber ihre Initialisierung nicht abgeschlossen haben. Eine Datenbank kann gestartet sein, aber noch keine Verbindungen annehmen. Ein interner Fehler kann einen Teil der Anwendung unbrauchbar machen, ohne dass der Hauptprozess beendet wird.
Für mich sind deshalb drei Zustände gedanklich voneinander getrennt:
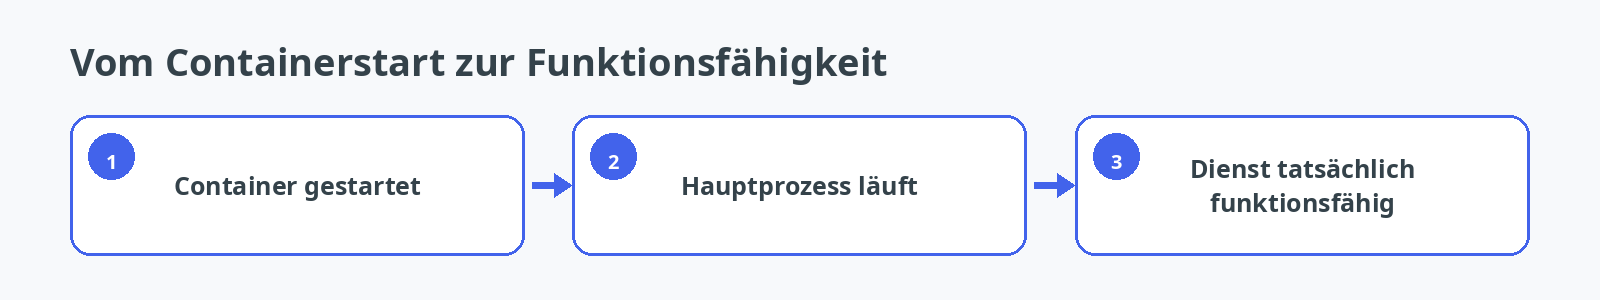
Ohne Healthcheck sieht Docker im Wesentlichen die ersten beiden Ebenen.
Mit einem sinnvoll gewählten Healthcheck kann ich zumindest einen Teil der dritten Ebene messbar machen.
Was Docker bei einem Healthcheck tatsächlich macht
Ein Healthcheck ist zunächst nichts Magisches. Docker führt in festgelegten Abständen einen Befehl im Container aus und wertet dessen Exit-Code aus.
Vereinfacht:
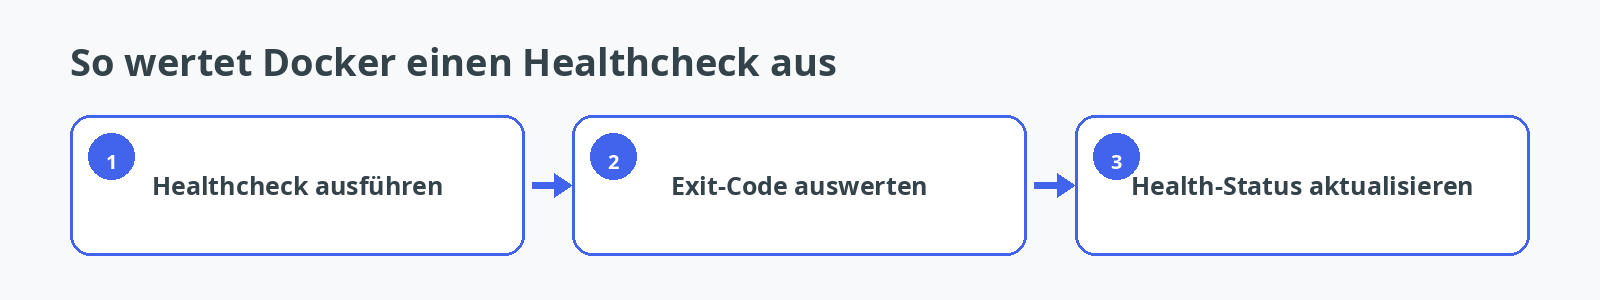
Docker verwendet daraus zusätzlich zum normalen Containerstatus einen Health-Status. Ein Container mit konfiguriertem Healthcheck beginnt zunächst als starting. Nach einem erfolgreichen Check wird er healthy. Nach der konfigurierten Anzahl aufeinanderfolgender Fehlschläge wird er unhealthy.
Das ist wichtig: unhealthy und stopped sind zwei verschiedene Dinge.
Ein Container kann also weiterhin laufen und gleichzeitig als nicht gesund erkannt werden.
Genau diese Information fehlt mir, wenn ich ausschließlich darauf schaue, ob der Containerprozess existiert.
Ein einfacher Healthcheck in Docker Compose
Für einen HTTP-Dienst könnte eine einfache Compose-Konfiguration beispielsweise so aussehen:
services:
  web:
    image: example/webapp:1.0
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 20s
Dabei haben die einzelnen Werte unterschiedliche Aufgaben.
test definiert die eigentliche Prüfung.
interval legt fest, in welchem Abstand sie ausgeführt wird.
timeout begrenzt, wie lange ein einzelner Versuch dauern darf.
retries bestimmt, wie viele aufeinanderfolgende Fehlschläge toleriert werden, bevor Docker den Container als unhealthy einstuft.
start_period gibt einer Anwendung Zeit für ihre Initialisierung. Fehlschläge während dieser Startphase werden nicht auf die maximale Anzahl der Fehlversuche angerechnet. Sobald während dieser Phase ein Check erfolgreich ist, gilt die Startphase für die Health-Auswertung als überwunden.
Diese Parameter sollte ich nicht einfach aus irgendeinem Beispiel übernehmen. Eine Datenbank, die nach einem Neustart erst Recovery-Arbeit erledigt, hat andere Anforderungen als ein kleiner statischer Webserver.
Der Healthcheck sollte die richtige Frage stellen
Der technische Aufbau eines Healthchecks ist meist nicht das eigentliche Problem.
Schwieriger ist die Entscheidung, was geprüft werden soll.
Ein Beispiel, das mir zu wenig aussagt, wäre:
healthcheck:
  test: ["CMD", "pgrep", "my-application"]
Damit weiß ich lediglich, dass ein Prozess mit einem bestimmten Namen existiert.
Genau das wusste Docker im Grunde schon auf einer niedrigeren Ebene.
Bei einem Webdienst ist eine lokale HTTP-Anfrage häufig aussagekräftiger:
healthcheck:
  test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
Aber auch das ist nicht automatisch perfekt.
Wenn /health unabhängig vom eigentlichen Zustand der Anwendung immer nur 200 OK zurückgibt, habe ich lediglich einen komplizierteren Prozesscheck gebaut.
Die entscheidende Frage lautet für mich daher:
Welche minimale Prüfung beweist, dass dieser Dienst seine wesentliche Aufgabe noch erfüllen kann?
Ein Health-Endpunkt darf trotzdem nicht alles testen
An dieser Stelle kann man auch in die andere Richtung übertreiben.
Angenommen, mein Webdienst benötigt eine Datenbank, einen Cache, einen externen API-Dienst und einen Mailserver. Ich könnte versucht sein, all diese Komponenten bei jedem Healthcheck vollständig zu testen.
Damit mache ich den Healthcheck allerdings selbst zu einem komplexen verteilten Testsystem.
Fällt ein externer Dienst aus, würde mein eigentlich funktionierender Webcontainer plötzlich ebenfalls unhealthy. Bei vielen Containern können solche Abhängigkeiten eine Fehlerkaskade erzeugen, die die eigentliche Ursache eher verschleiert.
Ich versuche deshalb, Healthchecks möglichst nah an der Verantwortung des jeweiligen Dienstes zu halten.
Ein Webdienst sollte beispielsweise zeigen können, dass seine Anwendung Anfragen verarbeitet. Ob eine Datenbank zusätzlich separat gesund ist, kann deren eigener Healthcheck feststellen.
Das ergibt ein wesentlich klareres Bild:
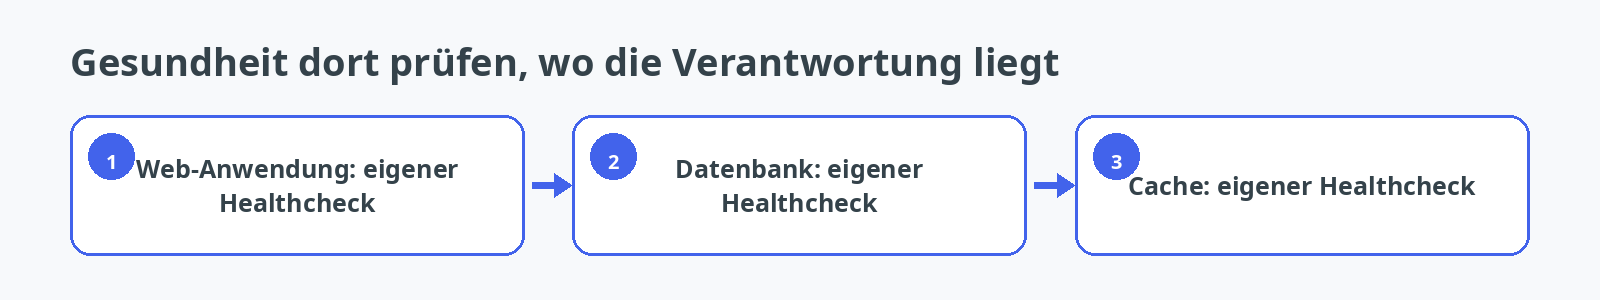
Erst auf einer darüberliegenden Monitoring-Ebene kann ich daraus ableiten, ob die gesamte Anwendungskette funktioniert.
Ein Docker-Healthcheck ersetzt für mich deshalb kein externes Monitoring.
Readiness und Container-Gesundheit sind nicht dasselbe
Besonders wichtig wird die Unterscheidung beim Start mehrerer voneinander abhängiger Dienste.
Ein klassisches Beispiel ist:
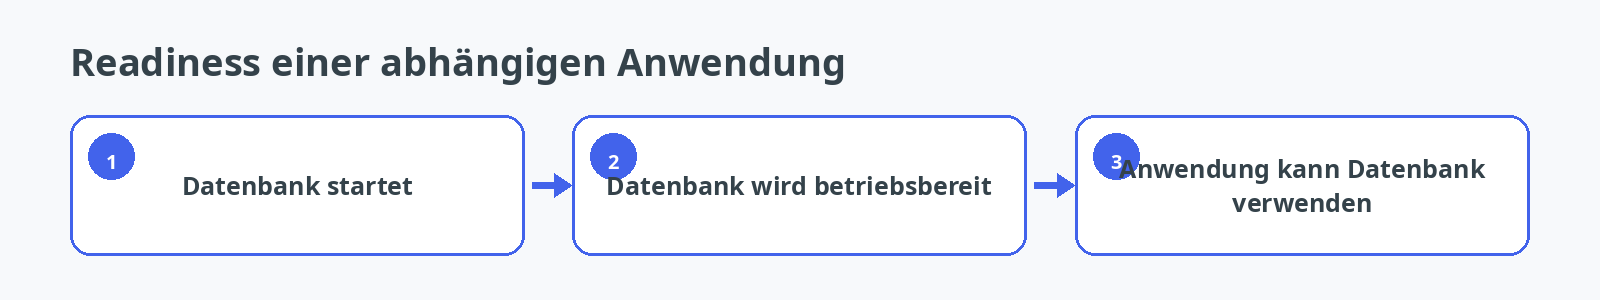
Dass der Datenbankcontainer gestartet wurde, bedeutet nicht automatisch, dass die Datenbank bereits Anfragen verarbeiten kann.
Genau hier reicht ein einfaches depends_on als reine Startreihenfolge nicht aus.
Docker Compose kann Abhängigkeiten mit einer Bedingung versehen:
services:
  app:
    image: example/app:1.0
    depends_on:
      db:
        condition: service_healthy

  db:
    image: postgres:18
    environment:
      POSTGRES_USER: example
      POSTGRES_DB: example
      POSTGRES_PASSWORD: change-me
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"]
      interval: 10s
      timeout: 5s
      retries: 5
      start_period: 30s
In diesem Beispiel wartet Compose beim Start der abhängigen Anwendung darauf, dass der Datenbankdienst seinen Healthcheck erfolgreich bestanden hat.
Für mich ist das ein wesentlich saubereres Modell als feste Wartezeiten nach dem Muster:
sleep 30
Eine feste Wartezeit weiß nichts über den tatsächlichen Zustand eines Dienstes. Nach fünf Sekunden könnte die Datenbank bereits bereit sein. Nach 30 Sekunden könnte sie immer noch nicht bereit sein.
Ein Healthcheck misst dagegen einen Zustand.
Ein Detail bei CMD und CMD-SHELL
Bei Healthchecks lohnt sich auch ein Blick auf die Form von test.
Eine Exec-Form sieht beispielsweise so aus:
test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
Hier wird das Programm direkt mit seinen Argumenten ausgeführt.
Eine Shell-Form kann dagegen so aussehen:
test: ["CMD-SHELL", "curl -f http://localhost:8080/health || exit 1"]
CMD-SHELL führt die Anweisung über die Standard-Shell des Containers aus. Das ist nützlich, wenn ich Shell-Funktionen wie Variablenexpansion, Pipes oder || benötige.
Ich bevorzuge die direkte CMD-Form, wenn ich keine Shell-Funktion brauche. Sie ist einfacher und reduziert unnötige Abhängigkeiten.
Entscheidend ist aber auch hier der konkrete Container: Das Werkzeug, das ich im Healthcheck aufrufe, muss im Image tatsächlich vorhanden sein.
Ein curl-Healthcheck hilft wenig, wenn ein bewusst minimales Image überhaupt kein curl enthält.
Healthchecks sollten keine Nebenwirkungen haben
Ein weiterer Grundsatz ist für mich: Eine Gesundheitsprüfung soll beobachten, nicht verändern.
Ich würde deshalb keinen Healthcheck bauen, der bei jeder Ausführung Datensätze erzeugt, Queues leert, Reparaturen ausführt oder andere Zustandsänderungen verursacht.
Ein guter Check lässt sich regelmäßig ausführen, ohne dass seine Ausführung selbst zum Betriebsrisiko wird.
Das ist besonders relevant, weil Healthchecks dauerhaft in kurzen Intervallen laufen können. Was bei einem manuellen Test harmlos erscheint, kann bei Tausenden automatischen Ausführungen ganz anders aussehen.
Wie ich einen fehlerhaften Healthcheck untersuche
Wenn Docker einen Container als unhealthy markiert, ist meine erste Reaktion nicht, den Healthcheck abzuschalten.
Ich möchte wissen, warum er fehlschlägt.
Einen schnellen Überblick liefert:
docker ps
Detaillierter kann ich den Health-Status eines Containers mit docker inspect betrachten:
docker inspect <container>
Für eine kompaktere Ausgabe kann ich beispielsweise gezielt den Health-Bereich ausgeben:
docker inspect \
  --format '{{json .State.Health}}' \
  <container>
Docker speichert Ausgaben der Healthcheck-Ausführungen im Health-Status. Das ist bei der Diagnose hilfreich, weil ich dadurch nicht nur unhealthy sehe, sondern häufig auch den Fehler des ausgeführten Prüfkommandos.
Danach führe ich den eigentlichen Check bei Bedarf manuell im Container aus:
docker exec <container> \
  curl -f http://localhost:8080/health
So kann ich unterscheiden, ob die Anwendung tatsächlich gestört ist oder ob mein Healthcheck selbst falsch konstruiert wurde.
Ein grüner Healthcheck beweist nicht die gesamte Anwendung
Auch ein sauberer Healthcheck hat Grenzen.
Wenn mein lokaler Web-Endpunkt erfolgreich antwortet, weiß ich noch nicht automatisch, dass:
- DNS von außen funktioniert,
- TLS korrekt terminiert wird,
- der Reverse Proxy erreichbar ist,
- die Firewall den gewünschten Verkehr zulässt,
- alle externen Abhängigkeiten verfügbar sind,
- ein Benutzer den vollständigen Workflow ausführen kann.
Deshalb sehe ich Healthchecks als eine Schicht in einem größeren Betriebsmodell:
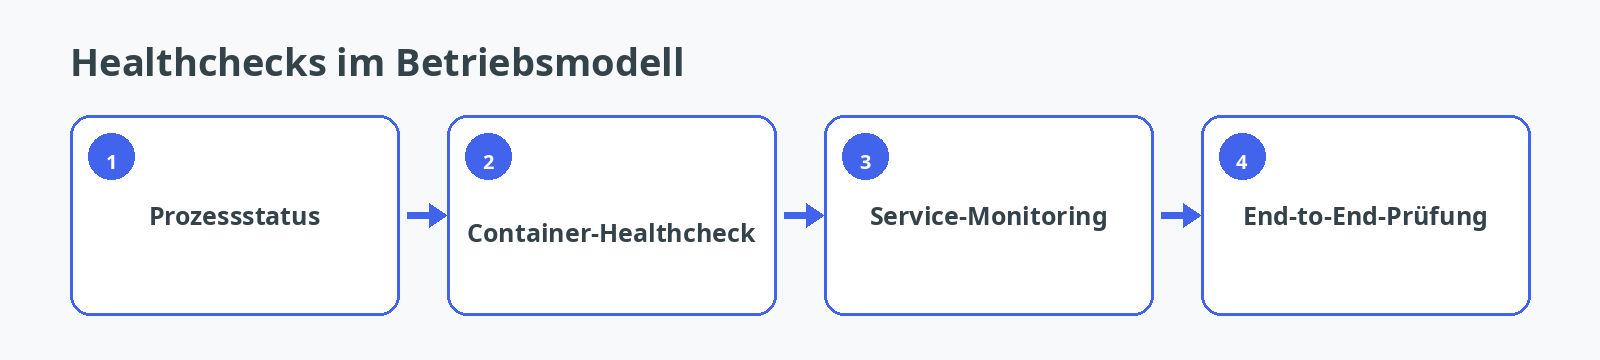
Jede Ebene beantwortet eine andere Frage.
Das ist für mich deutlich wertvoller als ein einzelnes grünes Symbol, das den Eindruck vermittelt, das komplette System sei geprüft.
Was ich bei neuen Containern heute zuerst festlege
Wenn ich einen neuen Dienst containerisiere, versuche ich den Healthcheck nicht erst nachträglich zu ergänzen.
Ich stelle mir früh drei Fragen:
- Woran erkenne ich, dass der Dienst wirklich bereit ist?
- Welche Prüfung kann ich regelmäßig und ohne Nebenwirkungen ausführen?
- Welche Fehler soll dieser Check bewusst nicht abdecken?
Gerade die dritte Frage verhindert, dass aus einem kleinen Healthcheck ein unüberschaubarer Integrationstest wird.
Danach teste ich nicht nur den Erfolgsfall.
Ich möchte auch sehen, was passiert, wenn die Prüfung absichtlich fehlschlägt. Wird der Container tatsächlich unhealthy? Ist die Fehlermeldung brauchbar? Reagieren abhängige Komponenten so, wie ich es erwartet habe?
Erst dann weiß ich, dass mein Healthcheck nicht nur syntaktisch vorhanden ist, sondern im Betrieb einen tatsächlichen Informationswert besitzt.
Mein Fazit
Docker-Healthchecks sind technisch einfach einzubauen. Einen guten Healthcheck zu entwerfen, ist deutlich anspruchsvoller.
Der entscheidende Unterschied liegt für mich zwischen:
Der Prozess läuft.
und:
Der Dienst kann seine Aufgabe erfüllen.
Ein Healthcheck sollte diese Lücke möglichst gezielt schließen.
Er sollte nah an der eigentlichen Funktion des Dienstes prüfen, keine unnötigen Nebenwirkungen verursachen und nicht versuchen, das komplette Monitoring zu ersetzen.
In Compose können Healthchecks zusätzlich helfen, Startabhängigkeiten sauberer abzubilden. service_healthy ist dabei wesentlich aussagekräftiger als die bloße Annahme, dass ein gestarteter Container sofort einsatzbereit ist.
Am Ende bleibt für mich derselbe Grundsatz, der sich bei vielen Betriebsthemen wiederholt:
Ein laufender Dienst ist noch kein nachweislich funktionierender Dienst.
Und genau deshalb gehören Healthchecks für mich nicht zur kosmetischen Docker-Konfiguration, sondern zu einem reproduzierbaren und nachvollziehbaren Betrieb.